Copilot Fusion : GitHub ne vous demande plus de choisir votre modèle, il choisit pour vous
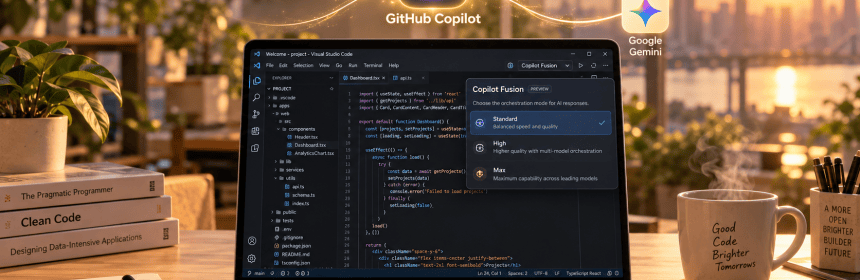
Depuis deux ans, les développeurs se livrent à un exercice quotidien digne d’une carte des vins : tel modèle pour le refactoring, tel autre pour le débogage, un troisième parce qu’un collègue a juré qu’il était “bien meilleur sur le TypeScript”. GitHub a décidé de retirer la carte des mains du client. Lors de sa conférence Universe du 28 octobre, l’éditeur a annoncé la disponibilité générale de Copilot Fusion, une option unique qui décide quels modèles d’IA traitent une tâche de développement et comment ils coopèrent.
L’idée n’est pas totalement nouvelle. GitHub avait présenté début septembre 2026 le Project HydraFusion, en préversion de recherche, pour mobiliser plusieurs modèles selon la tâche. Copilot Fusion en est la version industrialisée : le produit marie l’orchestration multi-modèles d’HydraFusion et la sélection automatique de modèle déjà présente dans Copilot, avec un objectif d’équilibre entre performance et coût.
Un routeur, pas un modèle
Le point technique essentiel est là : sélectionner Copilot Fusion dans le sélecteur ne revient pas à choisir un modèle. On choisit un système qui route et orchestre les modèles pour chaque tâche ; pour chaque prompt, Fusion détermine quels modèles utiliser et comment ils interagissent, le développeur se contentant de fixer un niveau d’effort. Le catalogue sous-jacent est bien garni : Fusion puise parmi des modèles d’Anthropic et d’OpenAI, dont Claude Opus 5.5, Claude Sonnet 5.5, GPT-6 Astra et GPT-6 Sol.
Trois niveaux d’effort sont proposés. Standard privilégie des modèles polyvalents pour le quotidien, High des modèles plus capables pour les tâches ardues et le raisonnement approfondi, Max les modèles les plus puissants pour les cas les plus exigeants. Par ailleurs, le système tient compte en temps réel de l’état de santé et de la disponibilité des services pour choisir ses modèles, ce qui ressemble fort à un équilibreur de charge doté d’un diplôme en génie logiciel.
Trois schémas d’exécution
C’est la partie la plus intéressante pour un architecte. Fusion ne se limite pas à aiguiller une requête vers un modèle ; il peut en enchaîner plusieurs selon trois schémas. En mode Single, un seul modèle traite la tâche. En mode Cascade, un modèle économe rédige une première réponse, puis un contrôle qualité décide de l’accepter ou d’escalader vers un modèle plus puissant. En mode Critique, un modèle produit un brouillon, un autre le relit, et le premier corrige. La documentation précise que dans ce dernier cas, plusieurs modèles peuvent critiquer en parallèle, leurs retours étant agrégés avant la révision.
On reconnaît des patterns bien connus des équipes qui construisent des agents : le “LLM juge”, l’escalade sur échec, la revue par les pairs. La nouveauté tient au fait que GitHub les intègre dans le produit et les déclenche automatiquement, sans que le développeur ait à écrire une ligne d’orchestration. Le junior qui rédige, le senior qui relit : GitHub a simplement réinventé la revue de code, version silicium.
Les chiffres, et ce qu’il faut en penser
GitHub met en avant les résultats de l’index Coding Agent d’Artificial Analysis. Fusion Max y obtient 60, à deux points de Claude Code avec Opus 5.5 Max, pour environ la moitié du coût API moyen par tâche, deux fois moins de jetons et un temps d’exécution réduit d’environ 40 %. En valeur absolue, la tâche revient à 5,59 dollars avec Fusion contre 11,42 dollars pour Claude Code avec Opus 5.5 en configuration max.
Le détail mérite toutefois qu’on s’y attarde. Fusion mène sur Terminal-Bench 4.0 avec 71, mais ne se classe que troisième sur FrontierCode avec 51, derrière Claude Code (56), et son score SWE-Atlas-QnA-AA reste en retrait à 57. Autrement dit, l’orchestration brille sur l’exécution en terminal mais ne rattrape pas le meilleur modèle seul sur les problèmes les plus difficiles. Ajoutons que les gains annoncés lors de la préversion étaient explicitement liés à des configurations précises. Un benchmark reste un benchmark : il mesure ce qu’il mesure, et votre monolithe Java de 2009 n’y figure pas.
Gouvernance : le sujet qui intéressera les DSI
Pour les organisations, le point le plus rassurant concerne le contrôle. Fusion n’utilise que les modèles autorisés par les politiques de l’entreprise et de l’organisation ; les administrateurs peuvent voir dans quel catalogue il pioche, et désactiver un modèle pour Fusion sans le retirer à l’ensemble des utilisateurs. Les modèles exclus par des politiques de résidence des données ou de conformité FedRAMP sont également écartés, ce qui reste à valider précisément dans un contexte européen. Enfin, les administrateurs peuvent imposer Fusion, à n’importe quel niveau d’effort, comme modèle par défaut.
Le témoignage d’AT&T illustre bien l’enjeu économique : les développeurs choisissaient souvent un modèle puissant pour une tâche complexe puis oubliaient de revenir à un modèle plus léger pour le quotidien. Qui n’a jamais laissé tourner Opus pour renommer une variable ?
La facture, ce grand point d’interrogation
C’est ici que l’enthousiasme doit être tempéré. Chaque modèle mobilisé par Fusion est facturé à son tarif standard ; une remise de 30 % est accordée pour une durée limitée sur les plans payants. La documentation est claire : Fusion High et Max pouvant faire appel à plusieurs modèles pour une même tâche, la consommation de crédits IA peut dépasser celle de Fusion Standard. Le coût moyen baisse peut-être, mais la prévisibilité unitaire, elle, s’éloigne. Le contexte renforce ce point : les clients GitHub Enterprise accèdent désormais à toutes les fonctions Copilot sans abonnement séparé, en ne payant que les crédits consommés. Un modèle à la consommation, piloté par un routeur dont les décisions ne vous appartiennent pas : les contrôleurs de gestion apprécieront.
Autre réserve, plus subtile : la reproductibilité. Si le routeur change d’avis d’une semaine à l’autre, ou selon la charge des fournisseurs, deux exécutions identiques peuvent emprunter des chemins différents. Pour du code généré, c’est acceptable ; pour un audit ou une analyse d’incident, c’est un paramètre de plus à documenter.
Disponibilité
Fusion est disponible sur tous les plans Copilot dans VS Code, l’application GitHub Copilot, Copilot CLI et les IDE JetBrains. GitHub a aussi introduit un routage expérimental entre des modèles installés localement et les services cloud, une piste intéressante pour les postes bien équipés et les données sensibles.
En conclusion
Copilot Fusion acte un déplacement stratégique : la valeur ne se situe plus seulement dans le modèle, mais dans le routeur qui décide qui fait quoi, et à quel prix. Pour Microsoft et GitHub, c’est aussi une manière habile de se rendre indispensables entre Anthropic et OpenAI. Pour les DSI, la promesse est réelle sur la maîtrise des coûts moyens, à condition de piloter finement les politiques de modèles et de surveiller la consommation de crédits. Le conseil reste le même que pour tout pilote automatique : on peut lâcher le volant, mais pas les yeux de la route.
Nous reparlerons de tout cela lors du prochain Briefing Calipia en décembre, pensez à vous inscrire si ce n’est pas déja fait !

