Ralentir l’IA générative américaine : le frein existe, mais en réalité, personne ne veut appuyer dessus
Il y a des questions qui se posent d’elles-mêmes dans les comités de direction depuis quelques mois. Celle du rythme en fait partie. Chaque trimestre apporte sa génération de modèles, ses nouveaux tarifs, ses ruptures d’architecture, et la question finit toujours par sortir : est ce que tout cela ne pourrait pas ralentir un peu, le temps que nos organisations digèrent ? Accessoirement, et malgré les déclarations (Anthropic suivi par OpenAI et SpaceX la semaine dernière) existe t il encore un acteur capable de décider d’un tel ralentissement, alors que la Chine publie un modèle de frontière toutes les trois semaines et que l’Inde distribue du GPU subventionné à ses startups ?
La réponse courte est non. La réponse longue mérite qu’on s’y attarde, parce qu’elle en dit long sur les risques réels que portent nos architectures.
Trois projets politiques qu’on confond en permanence
L’expression ralentir l’IA générative américaine recouvre trois intentions distinctes, qui n’ont ni les mêmes leviers ni les mêmes résultats.
- Ralentir les autres par rapport aux États Unis, d’abord. C’est la doctrine des contrôles à l’exportation depuis 2022, et c’est le seul des trois qui a produit des effets mesurables.
- Ralentir les entreprises américains elles mêmes, ensuite. C’est le débat sur la régulation, la sécurité et la gouvernance des modèles de frontière.
- Ralentir la diffusion mondiale de la capacité, enfin. C’est l’enjeu des modèles à poids ouverts, et c’est la partie que tout le monde a perdue sans s’en apercevoir.
Ces trois trajectoires ont divergé courant 2026. La première fonctionne à moitié, la deuxième est politiquement morte hors cas de sécurité nationale, la troisième appartient déjà au passé.
Le silicium : un levier réel, mais qui se retourne contre son opérateur
Commençons par ce qui marche. Le contrôle du calcul reste l’outil le plus efficace jamais déployé contre la diffusion d’une technologie logicielle, ce qui est en soi une jolie ironie.
Les chiffres sont sans appel. La production chinoise de processeurs d’IA avancés se situait en 2025 entre 1 et 4 pour cent de la production américaine. Epoch AI parvient au même ordre de grandeur côté Huawei : même en complétant sa mémoire domestique par des stocks étrangers, l’entreprise produirait moins de 4 pour cent du calcul IA de Nvidia en 2026, et pourrait rester autour de 1 pour cent jusqu’en 2028 si elle ne dispose que de HBM chinoise.
Le point technique mérite d’être compris finement, parce qu’il est contre intuitif. Le goulot d’étranglement chinois n’est pas la logique, c’est la mémoire. SMIC, avec son procédé N+2 en multipatterning DUV faute d’EUV, dispose de la capacité en tranches pour sortir les dies de plus d’un million d’accélérateurs Ascend par an. Mais la production domestique de HBM plafonne autour de deux millions de piles en 2026, de quoi assembler entre 250 000 et 300 000 packages seulement. Ajoutons que le stock de TSMC acquis via une société écran est épuisé depuis le début de l’année, et que la mémoire représente environ la moitié du coût d’un accélérateur. Huawei compense en câblant davantage de puces ensemble dans ses architectures SuperPoD, ce qui règle le problème de débit et en crée un autre, autrement plus coûteux : la consommation électrique… tiens donc.
Voilà pour l’efficacité. Venons en aux effets de bord, qui sont spectaculaires.
Nvidia détenait environ 95 pour cent du marché chinois des GPU dédiés à l’IA. Sa part est tombée sous les 60 pour cent, Huawei livrant près de 812 000 puces pour environ 20 pour cent du marché. Le séquencement politique y est pour beaucoup. Le H20 autorisé moyennant une taxe de 15 pour cent, puis boycotté par Pékin. Le H200 autorisé en décembre 2025 vers des destinataires vérifiés avec une surtaxe de 25 pour cent reversée au Trésor américain, puis interdit d’importation par Pékin quelques heures plus tard. Washington décide qui peut vendre, Pékin décide qui peut acheter, et les deux administrations changent d’avis à chaque trimestre. Pour un industriel, c’est le pire environnement de planification imaginable.
Enfin, le dispositif comporte une faille que ses concepteurs n’ont pas comblée. Les contrôles américains portent sur le transfert physique des puces, pas sur l’accès distant. ByteDance, Alibaba, Tencent ou Moonshot accèdent légalement à des GPU restreints via des centres de données situés en Thaïlande, en Malaisie ou au Japon. Le Remote Access Security Act, voté à la Chambre en janvier 2026, attend toujours le Sénat. On contrôle les cargaisons, pas les sessions SSH…
Les poids ouverts : le canal que le droit ne sait pas attraper
C’est le point aveugle de toute la doctrine, et celui qui intéresse directement nos architectures.
Une puce est un objet physique soumis à licence d’exportation. Un fichier de poids est une copie. En mai 2026, les modèles chinois à poids ouverts représentaient environ 61 pour cent de l’ensemble des tokens consommés sur OpenRouter, le principal routeur neutre de LLM, avec quatre des cinq modèles les plus utilisés. Llama, leader du monde ouvert il y a deux ans, a purement et simplement disparu du classement. Le routeur lui même a quadruplé en un an, passant d’environ 5 000 milliards de tokens hebdomadaires en avril 2025 à plus de 20 000 milliards un an plus tard. La Chine n’a pas seulement pris des parts, elle en a pris sur un marché qui explosait.
L’écart de capacité s’est comprimé en conséquence. Six points séparent aujourd’hui les meilleurs modèles ouverts de la frontière propriétaire sur l’indice d’Artificial Analysis, contre treize douze mois plus tôt. Sur LMArena, l’écart Elo entre ouvert et fermé est passé d’environ cent cinquante points à une trentaine.
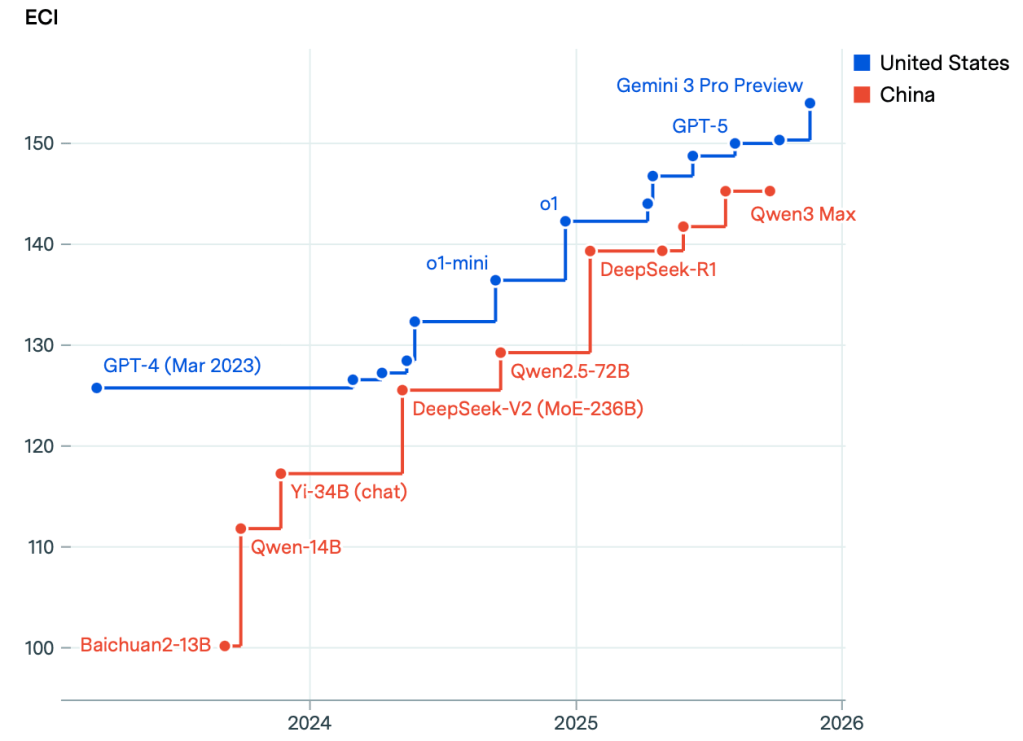
La mesure la plus rigoureuse reste celle d’Epoch AI. Depuis 2023, tous les modèles ayant atteint la frontière de capacité sont américains, et les modèles chinois accusent un retard moyen de sept mois, dans une fourchette de quatre à quatorze. Traduisons pour un directeur des systèmes d’information : les États Unis conservent la frontière, la Chine détient le marché. Sept mois de retard sur un modèle gratuit, auto hébergeable et sous licence MIT constituent une proposition commerciale supérieure à zéro mois de retard sur un modèle facturé en dollars et hébergé outre Atlantique.
L’Occident a desserré son propre frein
L’hypothèse d’un ralentissement par le droit se heurte à un fait embarrassant : les deux blocs régulateurs ont reculé la même année.
Aux États Unis, l’executive order 14365 du 11 décembre 2025 affiche l’objectif d’un cadre national minimalement contraignant et vise la prolifération des lois d’États. Il crée une task force contentieuse au département de la Justice, active depuis le 10 janvier 2026, et conditionne 42 milliards de dollars de crédits BEAD à l’abrogation de réglementations jugées excessives. Un cadre législatif publié le 20 mars 2026 recommande au Congrès une préemption large. Les États n’ont pas désarmé pour autant, mais leur production législative s’est réorientée vers la protection de l’enfance, les centres de données et le droit de la consommation, trois domaines explicitement exclus du champ de la préemption.
En Europe, le mouvement va dans le même sens. Le règlement 2026/1744, entré en vigueur le 27 juillet 2026, reporte les obligations haut risque de l’annexe III du 2 août 2026 au 2 décembre 2027, et celles de l’annexe I au 2 août 2028.
Attention au contresens, parce qu’il circule beaucoup dans les directions juridiques. Ce n’est pas une pause réglementaire. L’article 4 sur la maîtrise de l’IA reste une obligation de moyens contraignante pour tout déployeur, supervisée par les autorités nationales depuis le 3 août 2026. Deux nouvelles interdictions entrent en vigueur au 2 décembre 2026. Les pouvoirs d’exécution de la Commission sur les obligations GPAI sont effectifs depuis août 2026, avec des amendes pouvant atteindre 15 millions d’euros ou 3 pour cent du chiffre d’affaires mondial. Le calendrier a glissé de seize mois, le régime tient. Ceux qui ont mis leur programme de conformité au congé sabbatique auront une rentrée difficile 🙂
Le frein existe, on l’a vu fonctionner
Le fait le plus marquant de 2026 est passé « relativement » inaperçu hors des cercles spécialisés. Le 12 juin 2026, le département du Commerce a ordonné à Anthropic de suspendre l’accès mondial à ses modèles Claude Fable 5 et Mythos 5, à la suite d’un contournement soupçonné d’implications pour la sécurité nationale. L’accès a été rétabli le 1er juillet, après la levée des contrôles.
Retenons la démonstration. Un modèle de frontière peut être retiré du marché mondial en quarante huit heures, par décision administrative, sans passage devant un juge ni vote au Congrès. Le frein n’est pas théorique. Il est opérationnel.
Le reste du dispositif relève du volontariat. Le 19 août 2026, OpenAI a annoncé une pause de deux semaines sur l’entraînement par renforcement de modèles proches du déploiement, et confirmé la suspension indéfinie de son plus grand run RL planifié. Auto imposée, sur un seuil auto évalué, sans organe externe pour valider qu’elle était nécessaire ou suffisante. Le 28 juillet 2026, plus de 1 300 employés d’OpenAI, Anthropic, Google DeepMind et Meta signaient un texte demandant aux pouvoirs publics américains de soutenir la construction des outils techniques permettant de ralentir délibérément le développement automatisé de l’IA, si cela devenait un jour nécessaire. Notons la formulation : les ingénieurs demandent qu’on leur fabrique un frein. Une proposition de loi bipartisane déposée en juillet donnerait au département de la Sécurité intérieure le pouvoir d’ordonner l’arrêt d’un système couvert.
La conclusion est inconfortable. Le frein existe, il fonctionne, et il ne s’actionne que sur critère de sécurité nationale. Aucun mécanisme ne prévoit de ralentir au nom de la prudence économique, sociale ou industrielle.
Le vrai ralentissement sera subi, pas décidé
Si un coup de frein survient d’ici 2028, il viendra du réseau électrique et du marché du crédit.
Les quatre grands hyperscalers affichent environ 725 milliards de dollars d’investissements prévus en 2026, en hausse de 77 pour cent sur les 410 milliards de 2025. Microsoft a reconnu un carnet de commandes Azure d’environ 80 milliards qu’il ne peut pas honorer, faute d’électricité disponible. Près de 40 pour cent des projets de centres de données IA annoncés subissent des retards liés à l’infrastructure électrique, pas à l’approvisionnement en puces. Côté mémoire, les centres de données absorberont plus de 70 pour cent de la production haut de gamme en 2026, et Micron déclare sa capacité HBM vendue jusqu’en 2027.
Le montage financier constitue le point de fragilité le plus sérieux. Moody’s a chiffré début 2026 à environ 662 milliards de dollars les engagements de baux de centres de données signés mais non encore commencés, qui n’apparaissent pas au bilan sous les normes comptables américaines. Ce montant dépasse la dette consolidée inscrite au bilan des mêmes entreprises. J.P. Morgan estime à 1 500 milliards de dollars le volume d’obligations de qualité investissement nécessaire sur cinq ans pour financer la construction.
Le scénario dominant côté analystes n’est pas l’effondrement mais une réinitialisation progressive, comparable à la période 2000 à 2002, où les acteurs les plus fragiles cèdent en premier. Pour nos architectures, cela signifie une chose précise : un tel ralentissement frapperait d’abord la capacité d’inférence et les fournisseurs sous capitalisés, pas la recherche de frontière. Le contraire exact de ce qu’espèrent les partisans d’une pause.
L’Inde, ou comment rendre impossible tout régime restrictif mondial
L’Inde n’est pas un concurrent de frontière et ne le sera pas à cet horizon. Sa mission IndiaAI, dotée d’environ 1,25 milliard de dollars, a déployé quelque 34 000 GPU facturés autour de 65 roupies l’heure, vise 100 000 GPU publics fin 2026 et une capacité nationale au delà de 200 000 unités. Sarvam a publié en février 2026 deux modèles ouverts de 30 et 105 milliards de paramètres entraînés intégralement sur le calcul de la mission. Un consortium mené par l’IIT Bombay travaille sur un modèle à mille milliards de paramètres.
Son rôle réel est diplomatique, et il est décisif. La déclaration de New Delhi sur l’impact de l’IA, adoptée en février 2026, a été endossée par quatre vingt neuf pays et organisations internationales. Elle met en avant le partage des bénéfices, la souveraineté nationale et l’élargissement de l’accès aux ressources, avec une charte visant à garantir aux pays en développement un accès abordable au calcul, aux jeux de données et aux modèles de fondation. Texte non contraignant, comme ses prédécesseurs.
Dans le même mouvement, New Delhi a rejoint l’initiative américaine Pax Silica, lancée en décembre 2025 avec sept signataires et qui en comptait vingt cinq en août 2026. Deux architectures coexistent donc : une coalition d’approvisionnement pilotée par Washington, et une coalition de diffusion pilotée par New Delhi, avec l’Inde dans les deux. Aucune ne dispose du moindre mécanisme d’exécution. L’outillage juridique d’un vrai traité existe pourtant, avec des projets détaillant seuils de FLOP, limites de clusters et régime de vérification, mais leurs auteurs reconnaissent eux mêmes que la volonté politique de les signer n’existe pas.
Ce que cela change concrètement pour une DSI
Trois conséquences pratiques, qui valent plus que le débat géopolitique.
- Ne planifiez pas sur l’hypothèse d’un ralentissement. Le rythme de publication ne baissera pas. Vos architectures doivent absorber un changement de modèle par trimestre, pas par exercice budgétaire. Cela se traduit par une couche d’abstraction fournisseur, des jeux d’évaluation internes réutilisables et une chaîne de non régression sur vos cas d’usage métier.
- Le risque principal n’est pas la vitesse, c’est la volatilité d’accès. Un modèle de frontière peut disparaître du marché mondial sur décision administrative américaine, comme en juin 2026. Cela impose une clause de portabilité contractuelle et un modèle de repli à poids ouverts déjà qualifié, pas seulement identifié sur un slide.
- Les licences deviennent un point de vigilance juridique à part entière. DeepSeek V4 et GLM 5.2 sont distribués sous MIT, Qwen 3.6 sous Apache 2.0, mais Kimi K3 impose des seuils de revenus et d’attribution, et Alibaba a refermé son palier de frontière puisque Qwen3.7 Max et les préversions 3.8 Max sont accessibles uniquement par API. S’y ajoute la question de résidence des données : l’API hébergée de DeepSeek tourne sur des serveurs situés en Chine, ce qui fait basculer les traitements sous le droit chinois. L’auto hébergement des poids reste le seul moyen de conserver la juridiction, avec le coût d’exploitation que cela suppose.
Sur l’alternative européenne, Mistral a détaillé une trajectoire de 200 mégawatts en 2027 et 1 gigawatt en 2030, avec un site d’inférence aux Ulis ouvert au troisième trimestre 2026, des partenariats pluriannuels avec Airbus et BMW, et un hébergement des modèles et du calcul en Europe. Le positionnement est crédible sur les usages régulés. Arthur Mensch a lui même reconnu en juillet 2026 que son entreprise ne disposait pas encore des meilleurs modèles de langage, tout en ayant constamment réduit l’écart. C’est un arbitrage entre souveraineté et capacité, pas un remplacement à fonctionnalités équivalentes. Le présenter autrement à un comité d’investissement serait malhonnête. Et quelles seraient les décisions des utilisateurs si l’on désire n’autoriser que le seul Mistral ? Il y a des risques de voir surgir en masse le Shadow AI tant redouté (ne serais-ce par exemple que pour la générations d’images non supportées par Mistral AI).
En résumé
La question du ralentissement présuppose un pilote. Il n’y en a pas. Il y a des freins localisés qui fonctionnent bien sur le silicium, un accélérateur structurel qui passe par les fichiers de poids, et une contrainte physique qui finira par mordre sans que personne ne l’ait décidée.
Pour les directions informatiques, l’enjeu n’est donc pas d’attendre une accalmie qui ne viendra pas. Il est de construire des architectures qui supportent le changement permanent de fournisseur, de modèle et de régime juridique. C’est moins spectaculaire qu’un traité international, mais nettement plus utile au prochain comité d’architecture.
 Calipia : le blog
