Gemini Robotics ER 2 : Google apprend aux robots à travailler en équipe
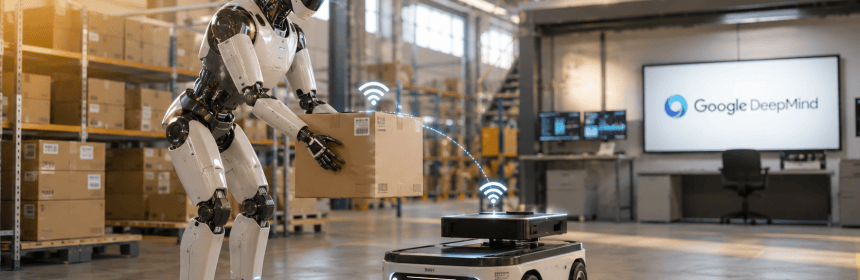
Google DeepMind a dévoilé le 30 juillet 2026 une nouvelle génération de sa famille Gemini Robotics, avec en vedette Gemini Robotics ER 2, un modèle de raisonnement incarné (embodied reasoning) qui fait office de cerveau haut niveau pour les robots. La promesse phare de cette version : permettre à plusieurs robots, y compris de types différents, de communiquer entre eux et de se répartir les tâches d’un même chantier. De quoi faire rêver n’importe quel DSI qui a déjà tenté de coordonner deux équipes informatiques sur un même projet, avec souvent moins de succès qu’un rover et un humanoïde apparemment.
Pour comprendre l’annonce, il faut revenir sur l’architecture. Depuis mars 2025, Google sépare le pilotage moteur du raisonnement. D’un côté, les modèles VLA (vision-language-action), qui convertissent une consigne en mouvement concret : Gemini Robotics 2 en est la version la plus aboutie, capable de contrôler un humanoïde des pieds aux doigts, avec des démonstrations réalisées sur l’Apollo 2 d’Apptronik équipé de mains SharpaWave, de mains Inspire, ou encore sur un bras Franka Duo, le tout avec un seul et même point de contrôle du modèle. De l’autre côté, Gemini Robotics ER, le module de raisonnement, qui observe l’environnement, planifie les étapes et délègue l’exécution motrice au VLA, traité techniquement comme un simple outil appelable, exactement sur le modèle du tool calling qu’on trouve déjà dans les architectures agentiques logicielles. Après les versions ER 1.5 en septembre 2025 puis ER 1.6 en avril 2026, ER 2 marque une étape supplémentaire dans cette lignée.
Trois apports techniques méritent l’attention des architectes. D’abord la compréhension vidéo continue : le modèle observe le déroulement d’une tâche en flux, estime sa progression, détecte les échecs et relance uniquement l’étape défaillante plutôt que de tout recommencer. Les chiffres communiqués par Google restent modestes sur ce point, avec 57,4 % de précision sur la classification de progression continue, mais bien plus solides sur la détection d’instants clés, avec 91,3 % de précision et une erreur moyenne de 0,96 seconde pour situer le moment exact d’un événement dans la vidéo. Ensuite, la suppression du fonctionnement séquentiel classique « je réfléchis puis j’agis » : ER 2 peut planifier l’étape suivante pendant que le robot exécute encore la précédente, grâce à une intégration à l’API Gemini Live en mode bidirectionnel, ce qui réduit les pauses de type stop and think. Enfin, la collaboration multi robots proprement dite, qui permet à des machines de nature différente (un robot à roues et un humanoïde par exemple) de reconnaître leurs forces respectives et de se répartir un flux de travail complexe via une compréhension sémantique partagée.
Sur le plan de l’infrastructure, ER 2 s’appuie sur Gemini 3.5 Flash, accepte des entrées entrelacées de texte, image, vidéo et audio avec une fenêtre de contexte allant jusqu’à 128 000 tokens, et peut générer jusqu’à 64 000 tokens en sortie. Les développeurs peuvent également brancher des outils supplémentaires dans la boucle de raisonnement, dont la recherche Google ou des fonctions personnalisées, ce qui rapproche encore un peu plus la robotique physique des pratiques d’orchestration agentique déjà familières aux équipes qui travaillent sur Copilot Studio ou les agents M365.
Reste la question qui intéresse forcément un RSSI : que se passe-t-il quand deux robots autonomes négocient entre eux la répartition d’une tâche sans supervision humaine directe ? Google met en avant un nouveau benchmark de sécurité, ASIMOV-Agentic, publié sur Hugging Face sous licence CC-BY-4.0, ainsi qu’un comportement de sécurité déjà présent dans les versions précédentes : le robot suspend son activité dès qu’une personne s’approche et ne reprend qu’une fois la zone dégagée. ER 2 afficherait de meilleurs résultats qu’ER 1.6 sur les tests de respect des consignes de sécurité et de proximité humaine. On notera cependant que la dextérité multi doigts reste un point faible assumé, avec des taux de réussite allant de 32 % à 92 % selon les tâches, un écart qui rappelle que la partie « intelligente » du système progresse plus vite que la partie mécanique.
Côté disponibilité, ER 2 est accessible en preview publique via l’API Gemini et Google AI Studio, ainsi qu’en preview privée sur la plateforme Gemini Enterprise Agent. Les modèles VLA et On-Device 2, eux, restent réservés à des partenaires sélectionnés, ce qui limite pour l’instant les scénarios d’intégration réelle en entreprise à la seule couche de raisonnement, sans contrôle moteur associé.
Pour un DSI, l’intérêt de cette annonce dépasse le seul cas d’usage robotique industriel. Elle illustre une convergence de plus en plus nette entre les architectures d’agents logiciels et les architectures robotiques : mêmes principes de délégation d’outils, mêmes questions de gouvernance sur l’autonomie décisionnelle, et probablement bientôt les mêmes débats sur la responsabilité en cas d’erreur de coordination entre systèmes autonomes. La robotique physique devient un cas d’école grandeur nature pour les problématiques d’agentic AI que beaucoup d’entreprises commencent tout juste à explorer côté logiciel.

